- EdTech · SAT
- Production
- 12K+ người dùng
Prep4u
Tự nghiên cứu và xây dựng end-to-end lớp chẩn đoán – luyện tập – giữ chân người dùng cho nền tảng luyện thi Digital SAT với 12.400+ học viên: Readiness Engine dự đoán điểm, Placement Test multistage adaptive và Sale Retention CRM.
Xem sản phẩm thực tế (mở trong tab mới)- Vai trò
- Full-stack · lead nhóm 2 developer
- Team
- 3–6 người
- Thời gian
- 01/2026 – 08/2026
- Trạng thái
- Đang vận hành
12.4K+
Người dùng đăng ký
~110K
Câu hỏi trong ngân hàng
6
Tính năng phụ trách end-to-end
30
REST API trong CRM
 Laravel
 Livewire
 Alpine.js
 MySQL
 Redis
Bối cảnh
Prep4u là sản phẩm của Protean Studios: nền tảng luyện thi trọng tâm Digital SAT (thêm IELTS, Tốt nghiệp THPT, ĐGNL), có web và mobile app, kinh doanh theo gói subscription Start / Focus / Master. Hệ thống là một monolith Laravel lớn đang vận hành — khoảng 535 route, 178 model, 411 Livewire component, ~6.800 commit từ 2023 với hơn 10 developer từng tham gia.
Tôi tham gia từ 01/2026 đến 08/2026 và nhận trọn nhóm tính năng về chẩn đoán năng lực, phân tích học tập và retention.
Vấn đề
Ba khoảng trống, ở ba phía khác nhau của sản phẩm:
- Học sinh luyện nhiều nhưng không biết mình đã sẵn sàng tới đâu, điểm dự kiến bao nhiêu và yếu ở kỹ năng nào → luyện lan man, dễ nản.
- Người dùng mới không có cách nhanh để biết trình độ → onboarding yếu, khó dẫn tới gói trả phí.
- Team sale và product không đo được retention một cách nhất quán, không biết subscriber nào sắp rời bỏ, sale không biết hôm nay nên liên hệ ai, nói gì, và liên hệ có hiệu quả không.
Vai trò của tôi
Tôi tự nghiên cứu, thiết kế thuật toán và làm end-to-end 6 tính năng — từ phân tích nghiệp vụ, thiết kế thuật toán và database, backend/API, UI Livewire, GA4 tracking đến deploy production và hotfix:
- Readiness Engine — điểm sẵn sàng thi SAT (0–100) và dự đoán điểm 400–1600.
- Weakness Map — phân tích điểm yếu theo cây kỹ năng.
- Placement Test — bài test đầu vào multistage adaptive theo format Digital SAT, và Quick Diagnostic 16 câu.
- Retention Metrics Dashboard — retention theo cohort D1/D7/D30.
- Sale Retention CRM — tính năng tôi tự đề xuất: hàng đợi liên hệ ưu tiên cho team sale.
Tôi lead một nhóm 2 developer: chia task, review code và thiết kế giải pháp.
Ràng buộc
- Dữ liệu thưa: nhiều người mới chỉ làm vài bài; accuracy thô rất nhiễu (3/3 câu đúng = 100%).
- Có thể "hack" điểm: click thật nhanh hoặc đoán bừa vẫn tạo ra số liệu trông đẹp.
- Một engine, nhiều nơi dùng: dashboard web, các service phân tích và mobile API phải ra cùng một con số.
- Codebase lớn đang chạy production, nhiều người cùng sửa → ưu tiên tái sử dụng hạ tầng có sẵn (phòng thi SAT) thay vì viết mới.
- Hạ tầng: Redis dùng chung cho cache và session (không được flush), không có cron cập nhật trạng thái gói.
- Bài full diagnostic dài 134 phút → rủi ro mất mạng, đóng tab, hết giờ giữa chừng.
Kiến trúc
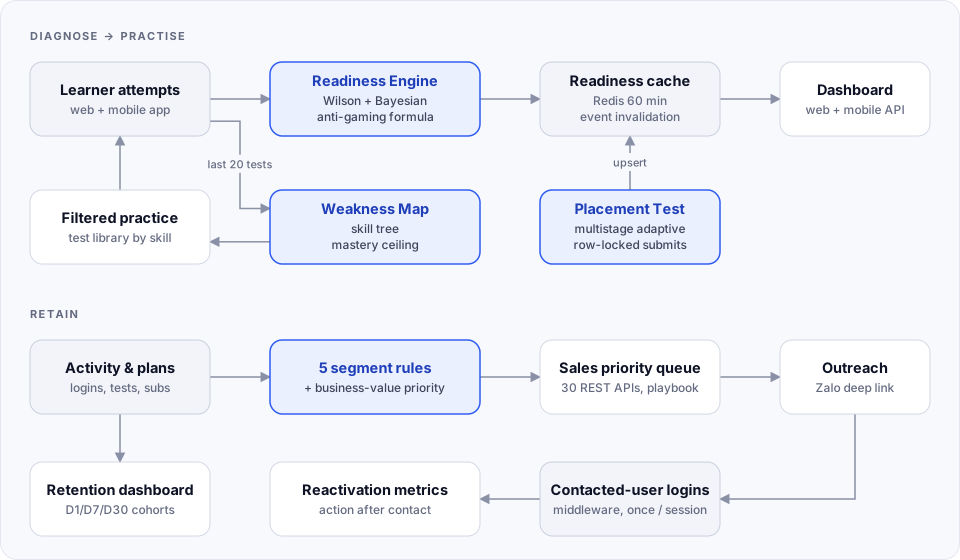
- Readiness Engine là service singleton đọc 10 bài thi hoàn thành gần nhất, kết quả cache trên Redis 60 phút. Một Model Observer trên
UserQuizxoá cache chỉ khiis_completedchuyển sangtrue. Kết quả lưu vào bảnguser_readiness_cache(unique theo user × exam_type) — bảng này dùng chung với Placement Test. Một engine phục vụ dashboard web,StudyInsightService,AdvancedAnalyticsServicevà mobile API. - Weakness Map đọc 20 bài gần nhất theo cây kỹ năng 2 cấp. Mỗi thẻ điểm yếu link thẳng tới thư viện đề đã lọc đúng kỹ năng → học sinh luyện → dữ liệu mới quay lại engine. Vòng lặp chẩn đoán → luyện tập khép kín.
- Placement Test chạy trên phòng thi SAT có sẵn: RW Module 1 → RW Module 2 (Easy/Hard) → nghỉ 10 phút → Math Module 1 → Math Module 2 (Easy/Hard). Kết quả upsert vào
user_readiness_cachevớiassessment_source = 'full_diagnostic', và dashboard ưu tiên điểm placement hơn điểm ước tính từ luyện tập. Quick Diagnostic rẽ nhánh trên cùng hạ tầng bằngexam_type = 'quick'. - Retention & CRM: truy vấn cohort → 9 endpoint dashboard; 5 segment rule → priority score → priority queue API → phân công sale → Zalo deep link → middleware ghi event login của người đã được liên hệ → đo reactivation.
Quyết định kỹ thuật chính
Dự đoán điểm thận trọng: Wilson score lower bound + Bayesian smoothing
- Vấn đề: với ít câu, accuracy thô dao động mạnh và dễ cho điểm dự kiến ảo.
- Lựa chọn: dùng Wilson score lower bound (khoảng tin cậy 95%) và Bayesian (Laplace) smoothing, blend theo độ tin cậy
c = min(1, N/50); điều chỉnh bonus/penalty theo accuracy câu khó. Khoảng điểm dự kiến co hẹp dần từ ±150 xuống ±30 trong 100 câu đầu, kèm 5 mức confidence. - Lý do: người ít dữ liệu nhận ước lượng thận trọng với khoảng rộng; người nhiều dữ liệu nhận điểm sát thực tế — và cả hai đều thấy rõ độ tin cậy.
- Trade-off: người mới thấy điểm thấp và khoảng rộng hơn kỳ vọng. Tôi bù bằng thông điệp chẩn đoán cụ thể ("cần làm thêm N câu để mở khoá điểm cao hơn") thay vì nới công thức.
Chống điểm ảo nằm ngay trong công thức
- Vấn đề: click nhanh hoặc đoán bừa không được phép đẩy điểm lên.
- Lựa chọn:
Readiness = Accuracy×0.55 + Volume×0.15 + HardAccuracy×0.25 + Time×0.05(trọng số trongconfig/readiness.php).- Hệ số phạt theo accuracy: dưới 50% ×0.3, dưới 60% ×0.5.
- Volume chỉ đếm câu đúng (mục tiêu 68,6 = 98 câu × 70%), có hệ số độ tin cậy theo số bài.
- Time score chỉ tính thời gian của câu đúng, trọng số theo độ khó (0.5 / 1.0 / 1.5).
- Volume ceiling 5 mức: dưới 20 câu thì trần 20 điểm … từ 200 câu trở lên mới tới 100.
- Lý do: mỗi cách gian lận đều bị một thành phần vô hiệu hoá, thay vì một lớp kiểm tra riêng dễ bị lách.
- Trade-off: công thức khó giải thích hơn → tôi xây thêm tool admin Readiness Debug: xem từng thành phần điểm, mức phạt, trần, accuracy từng bài và histogram thời gian trả lời (bucket ≤5 giây để phát hiện spam click) — để CS giải thích điểm cho học viên và để tôi tinh chỉnh trọng số.
Cache theo sự kiện thay vì TTL ngắn
- Vấn đề: tính readiness tốn nhiều query, nhưng sau khi làm xong bài học sinh phải thấy điểm mới ngay.
- Lựa chọn: cache Redis 60 phút + Model Observer invalidate khi bài chuyển sang hoàn thành.
- Trade-off: thêm một nơi phải giữ đúng logic invalidation; đổi lại không tính lại thừa và không trả số liệu cũ.
Placement Test: multistage adaptive thay vì adaptive từng câu
- Vấn đề: cần bài chẩn đoán đúng trải nghiệm Digital SAT và ước lượng được năng lực.
- Lựa chọn: multistage adaptive 2 stage như Digital SAT thật. Sau mỗi Module 1, ước lượng năng lực θ (−3 đến +3) từ accuracy có trọng số độ khó (easy 0.8, medium 1.0, hard 1.25); θ ≥ 0,5 → Module 2 Hard. URL không lộ nhánh (người dùng chỉ thấy
rw-module-2, server tự map Easy/Hard) và không thể quay lại module trước. - Lý do: đúng format thi thật, tái sử dụng được phòng thi SAT có sẵn (timer, review, highlight, Desmos) và không cần calibrate tham số IRT cho từng câu hỏi.
- Trade-off: ước lượng kém chính xác hơn CAT/IRT; pool hiện bằng đúng blueprint nên mọi người dùng nhận cùng một bộ câu hỏi.
Chống race condition khi nộp bài
- Vấn đề: double submit, nhiều tab, mạng chập chờn khi nộp đáp án và chuyển module.
- Lựa chọn: lưu đáp án và kết thúc module trong DB transaction với
lockForUpdatetrên session; chặn đáp án trùng; kiểm tra quyền sở hữu session. Batch submit: đáp án giữ trong localStorage và gửi một lần khi hết module, mỗi đáp án lưu trong transaction riêng để giảm lock contention. Câu bỏ trống tính là sai. - Trade-off: đáp án chưa gửi nằm phía client tới cuối module → bù bằng tự nộp khi hết giờ, resume từ intro/dashboard/URL và dọn state cũ.
CRM: rule + priority score có thể giải thích, thay vì mô hình học máy
- Vấn đề: sale cần biết hôm nay gọi ai trước và vì sao.
- Lựa chọn: 5 segment rule theo thứ tự ưu tiên (CANCEL_RECENT, EXPIRED_RECENT, CHURN_RISK, SILENT_SUBSCRIBER, POTENTIAL_BUYER) và priority score theo giá trị kinh doanh (số ngày không hoạt động, vừa huỷ gói, tier, giá trị gói, mức luyện tập, xu hướng giảm); POTENTIAL_BUYER dùng công thức riêng, ưu tiên người đang hoạt động. Chấm điểm hàng loạt bằng 4 query pre-fetch để tránh N+1.
- Lý do: dữ liệu chưa đủ cho ML; sale và quản lý hiểu và chỉnh được rule.
- Trade-off: trọng số phải tinh chỉnh tay theo phản hồi của sale.
Retention trên cohort cố định
- Vấn đề: cách tính ngây thơ cho ra D30 > D7 hoặc cohort chưa đủ ngày quan sát.
- Lựa chọn: rolling retention trên một cohort cố định — người có lần làm bài đầu tiên cách đây 31–61 ngày — để mọi mốc D dùng cùng một cohort, luôn có D1 ≤ D7 ≤ D30, có xử lý right-censoring; song song exact retention kiểu GA (D1/D7/D14/D30) và trend 12 tuần.
Chỉ log những gì cần để đo
- Lựa chọn: middleware ghi event login chỉ cho người đã được sale liên hệ, mỗi session một lần (luôn cập nhật
last_login_at). - Lý do: bảng event gọn mà vẫn đo được tỷ lệ "có hành động sau liên hệ" và reactivation trong 7 ngày.
Đánh đổi
- Multistage vs CAT/IRT: đơn giản, đúng format, tái dùng phòng thi — đổi lại độ chính xác ước lượng thấp hơn.
- Rule-based vs ML cho segment và priority: minh bạch, chạy được với ít dữ liệu — đổi lại phải tinh chỉnh tay.
- Trigger Engine giai đoạn 1: thiết kế đủ 4 loại điều kiện và 4 loại hành động, nhưng các action gửi Zalo/email/voucher hiện chỉ ghi log; gửi Zalo là bán tự động (render tin cá nhân hoá rồi mở deep link) — ra mắt nhanh, chưa tự động hoàn toàn.
- Tier gating trên trang kết quả phục vụ upsell (Weakness Map và roadmap cho gói trả phí, AI Coach cho Focus/Master), nhưng người dùng free vẫn nhận điểm dự kiến và mức độ.
- Ngắn hạn vs mở rộng: rolling retention đang chạy
exists()theo từng user — đủ cho quy mô hiện tại, cần tối ưu khi lớn hơn.
Điểm nổi bật khi triển khai
- Readiness: accuracy theo độ khó lấy bằng một câu SQL group by trên
user_quiz_details ⨝ questions; thời gian lý tưởng suy từ cấu trúc đề thật (quiz_sections), hệ số medium 1,13 hiệu chỉnh từ dữ liệu đo thực tế (93s so với 82s). Lớp lập kế hoạch: ước tính điểm tăng mỗi tuần, đánh giá mục tiêu "khả thi" hay "thử thách" theo ngày thi, roadmap 3 giai đoạn và coach comment tự động. - Weakness Map: accuracy có trọng số độ khó (1 / 1,5 / 2) nhân trọng số thời gian giảm tuyến tính từ 2× xuống 0,5×; mastery ceiling 4 mức (chỉ làm câu dễ thì tối đa 50%…), UI ghi rõ lý do ("cần thêm câu khó (1/3)"); risk score 0–100; 5 trạng thái kỹ năng; category có coverage dưới 30% bị đánh critical; ngưỡng lọc nhiễu. Livewire lazy-load sub-skill; 10 sự kiện GA4 đo funnel view → click kỹ năng → bắt đầu luyện.
- Placement Test: blueprint 6 module, phân bổ đều 8 domain kỹ năng, pool 147 câu không trùng; mỗi lượt 98 câu (27/27/22/22), 134 phút; điểm section
200 + 600 × weighted accuracy(±80); seeder dựng pool từ 300 đề mới nhất, lấy dư ×3 mỗi ô blueprint và in báo cáo kiểm chứng; mọi tính toán trang kết quả có try/catch và fallback. Quick Diagnostic 16 câu dùng chung session, phòng thi và pipeline nộp bài → hoàn thành trong khoảng một tuần. - Sale Retention CRM: 5 bảng mới (~20 index), 9 loại event; priority queue với 9 bộ lọc; playbook cấu hình được (kịch bản theo segment, 4 KPI mục tiêu, 6 mẫu tin Zalo với 16 biến);
retention:auto-assign --dry-run --segment;retention:validate-data --sync --fixkiểm tra go/no-go và backfilllast_login_atbằng correlated UPDATE; traitExcludesTestAccountsdùng lại ở 8 class; middleware phân quyền theo role; 30 REST endpoint. - Retention Dashboard: 9 JSON endpoint, 4 tab Chart.js chỉ tải khi mở; phân trang trên danh sách ID trước rồi enrich một lần để tránh N+1; loại tài khoản test và lượt thi chưa hoàn thành.
Kết quả
- Toàn bộ chạy production trên prep4u.vn với 12.400+ người dùng đăng ký.
- Một Readiness Engine dùng chung cho dashboard web, các service phân tích và mobile API.
- Placement Test và Quick Diagnostic trở thành phễu onboarding và upsell (tier gating, event
placement_test_complete). - Team sale có hàng đợi liên hệ ưu tiên hằng ngày và đo được reactivation sau liên hệ.
Bài học
- Với dữ liệu thưa, thận trọng nhưng giải thích được tốt hơn chính xác giả tạo: khoảng điểm co dần và thông điệp "cần thêm N câu" giúp học sinh tin con số.
- Chống gian lận nên nằm trong mô hình, không phải một lớp kiểm tra đắp thêm.
- Tool debug xây song song với thuật toán giúp cả vận hành lẫn chính mình tinh chỉnh nhanh.
- Đo lường (GA4 funnel, event sau liên hệ) cần thiết kế cùng tính năng, không bổ sung sau.
- Hướng tiếp theo: random hoá pool Placement Test, tối ưu rolling retention và bộ lọc "action after contact", tự động hoá Trigger Engine.